
Sovereign AI · 28 août 2026
vLLM 0.28 relève le niveau de l’inférence privée
vLLM 0.28.0 est arrivé le 26 août 2026 avec un ensemble dense de changements dans le moteur d’inférence : travaux d’optimisation pour Kimi-K3, support du sparse MLA de DeepSeek V4, maturation de Model Runner V2, offload hiérarchisé du KV cache, travaux sur le frontend Rust/gRPC, valeurs par défaut mises à jour, et nouveaux artefacts de release pour les builds CUDA, ROCm, CPU et XPU. Sur le papier, c’est exactement le type de release que recherchent les équipes Sovereign AI : une couverture de modèles plus large, une meilleure utilisation GPU, et une trajectoire plus claire vers une inférence privée à haut débit sans envoyer de données réglementées vers une API externe.
Pour les institutions financières luxembourgeoises et européennes, le message n’est pas simplement « mettre à niveau vLLM ». Le message est que l’inférence privée est devenue un plan de contrôle de production. Si un administrateur de fonds, un AIFM, une banque privée ou un fournisseur RegTech utilise des LLM locaux pour le triage de tickets, la recherche documentaire, les runbooks opérationnels, l’enrichissement d’alertes ou l’automatisation développeur, la couche d’inférence se trouve désormais proche de workflows réglementés. Cela place le versioning de vLLM, la compatibilité des modèles, l’ordonnancement GPU, le routage des prompts et l’observabilité dans la même conversation de résilience opérationnelle que Kubernetes, les reverse proxies, l’identité, la journalisation et la réponse à incident.
Impact réglementaire et business
Le business case de vLLM reste solide. L’inférence privée peut réduire l’exposition récurrente aux API, améliorer la latence des outils internes, et maintenir le contexte opérationnel sensible dans une infrastructure contrôlée. Dans un environnement financier européen, cela compte. Un modèle qui résume des incidents de paiement, classe des documents d’onboarding client, inspecte des exceptions d’opérations de fonds ou aide un SRE à interpréter de la télémétrie de production peut toucher des données personnelles, des informations commerciales confidentielles ou des détails de sécurité opérationnelle. Sous GDPR, DORA et l’EU AI Act, ce n’est pas une expérimentation d’ingénierie anodine.
vLLM 0.28.0 montre aussi pourquoi les équipes dirigeantes devraient traiter l’infrastructure IA open source comme une plateforme gouvernée, et non comme une simple mise à jour de bibliothèque. Les release notes listent des changements orientés performance, comme le support Decode Context Parallel, des kernels FlashKDA fusionnés, l’optimisation du combined all-gather, des budgets adaptatifs de speculative tokens, et le sharding de shared experts. Ces éléments ont de la valeur quand les budgets GPU sont sous pression. Si une banque peut servir la même charge sur moins de H100, de systèmes de classe MI300, ou de matériel interne mixte, le ROI est direct : moins de pression capex, une meilleure utilisation, et moins de tentation de contourner la gouvernance via des outils SaaS non maîtrisés.
Mais il existe un versant risque opérationnel. Des issues GitHub publiques ouvertes contre v0.28.0 incluent déjà des rapports de prefix caching avec MTP produisant des réponses malformées sur un modèle hybride Mamba/GDN, ainsi qu’un autre rapport d’inférence distribuée DeepSeek-V4-Pro bloquée lors du démarrage multi-nœuds. Cela ne prouve pas que la release soit globalement dangereuse. Cela prouve que les moteurs d’inférence IA ont désormais le même profil de risque de release que les bases de données, les hyperviseurs et les control planes Kubernetes. La correction, le comportement au démarrage, la stratégie de cache et l’exécution distribuée doivent être testés contre vos modèles et votre charge de travail — pas seulement contre les benchmarks fournisseur.
Pour les organisations de l’ère DORA, cela compte parce qu’un assistant IA connecté aux opérations de production peut amplifier les erreurs. Une réponse corrompue dans un chatbot est irritante. Une réponse corrompue dans un workflow d’incident, une revue d’accès, un comité de changement ou un processus de triage d’une plateforme de paiement peut devenir un événement de risque opérationnel. La question de conformité n’est plus seulement « où le modèle est-il hébergé ? ». Elle est aussi : « comment prouvez-vous que le chemin de model-serving est versionné, testé, supervisé, récupérable et contraint ? »
Schéma architectural et opérationnel
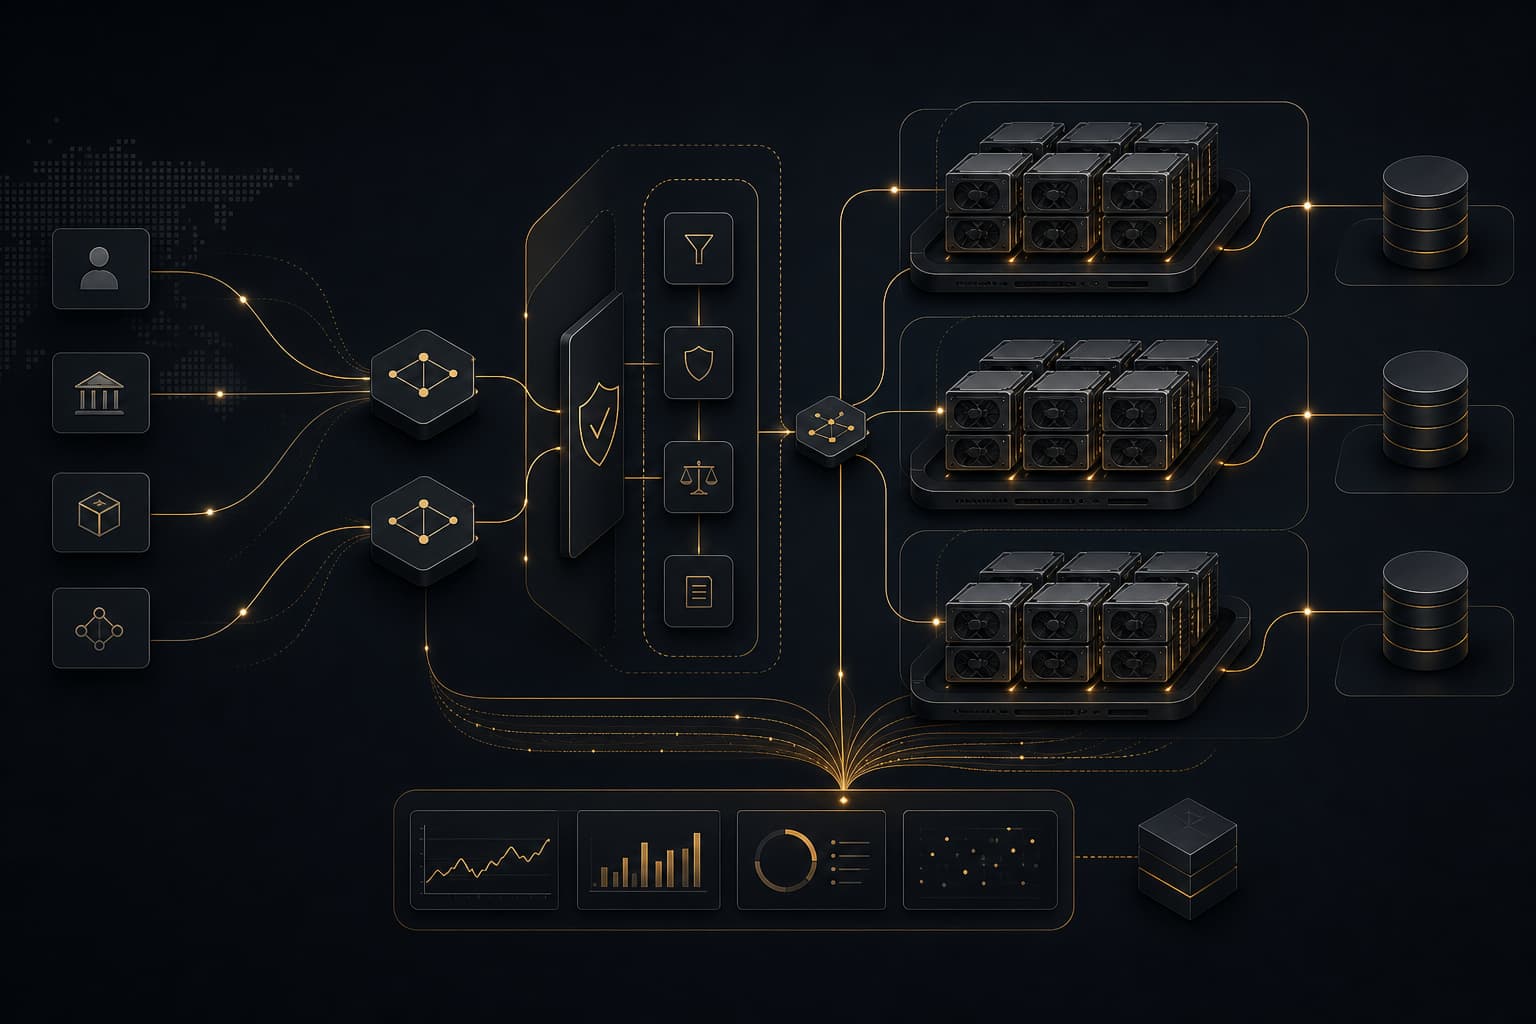
Une architecture crédible d’inférence privée commence par la séparation des responsabilités. vLLM ne devrait pas être exposé comme un endpoint interne non médié où chaque outil, agent et analyste peut envoyer du trafic arbitraire. Placez-le derrière une couche d’ingress contrôlée : Nginx, F5, HAProxy ou une API gateway avec mTLS, routage conscient de l’identité, limites de requêtes et segmentation réseau claire. Si l’endpoint du modèle devient un service d’infrastructure partagé, traitez-le comme tel.
La couche suivante est la gouvernance du modèle et du runtime. Épinglez dans Git l’image de conteneur vLLM, le runtime CUDA ou ROCm, la révision du modèle, le tokenizer, le format de quantisation et les paramètres de démarrage. Stockez-les comme du code, relisez-les comme de l’infrastructure, et promeuvez-les à travers les environnements. Un passage d’une release mineure de vLLM à une autre devrait déclencher une matrice de tests : chargement du modèle, latence du premier token, débit, validité des sorties structurées, parsing des tool calls, comportement de refus, correction des cache hits, démarrage multi-nœuds et reprise après défaillance.
Pour les clusters GPU, Kubernetes peut aider, mais ce n’est pas magique. Utilisez des node labels pour la génération GPU, du scheduling topology-aware lorsque disponible, des taints pour les nœuds d’inférence, et des namespaces dédiés aux workloads IA. Si vous exécutez vLLM sur bare metal ou sur des nœuds GPU adossés à Proxmox, gardez la même discipline : scripts de déploiement immuables, configuration gérée par Ansible, piles de drivers connues comme bonnes, et rollback contrôlé. L’objectif opérationnel est simple : si v0.28 améliore le débit mais casse un modèle critique en production, vous devez pouvoir revenir en arrière en quelques minutes, pas reconstruire la plateforme pendant un week-end.
L’observabilité est non négociable. Au minimum, collectez l’utilisation GPU, la pression mémoire, la latence des requêtes, la profondeur de file, le débit de tokens, les taux d’erreur, les événements de chargement de modèle, les redémarrages de processus et les métriques de gateway amont. Zabbix ou Prometheus peuvent couvrir la santé de la plateforme ; Grafana donne la vue opérationnelle ; OpenTelemetry peut relier les appels de modèle aux exécutions de workflows lorsque c’est pertinent. Pour les workflows réglementés, journalisez soigneusement les métadonnées et les décisions, mais évitez de stocker des prompts contenant des données sensibles sauf s’il existe une politique de rétention et un modèle d’accès clairs.
L’architecture devrait aussi inclure une frontière d’agent. Si LangGraph, des outils MCP, des scripts internes ou des intégrations de ticketing appellent vLLM, définissez ce que l’agent peut lire, ce qu’il peut écrire, et où une approbation humaine est obligatoire. La recherche vectorielle via Qdrant ou une autre base locale devrait utiliser des collections à périmètre défini, et non un grand knowledge lake incontrôlé. Un assistant IA capable de retrouver des runbooks est utile. Un assistant IA capable de retrouver des secrets, des fichiers client et des notes d’incident privilégiées parce que tous les embeddings ont été mélangés est un échec de gouvernance.
Ce que cela change en pratique
- Promouvoir vLLM via des gates de release. Traitez v0.28.0 comme une mise à niveau de plateforme nécessitant staging, tests de charge et rollback, et non comme un bump routinier de package Python.
- Tester la correction, pas seulement la vitesse. Validez les sorties structurées, le JSON des tool calls, les citations RAG, les workloads à préfixes répétés et les prompts déterministes avant le déploiement en production.
- Séparer l’inférence de l’orchestration. Gardez vLLM comme couche de serving ; placez les politiques, les approbations, l’état des workflows et les audit trails dans la couche d’orchestration.
- Tout épingler. Image de conteneur, révision de modèle, tokenizer, driver GPU, runtime CUDA/ROCm, format de quantisation et flags de démarrage doivent être reproductibles.
- Surveiller les comportements liés au cache. Le prefix caching et le speculative decoding sont attractifs pour les coûts et la latence, mais ils doivent être validés pour chaque famille de modèles.
- Concevoir pour des opérations souveraines. Gardez les prompts réglementés, embeddings et télémétrie dans une infrastructure européenne contrôlée, sauf exception documentée.
- Construire la preuve pour DORA. Les dashboards ne suffisent pas. Conservez les enregistrements de déploiement, résultats de tests, approbations de changement, chronologies d’incident et preuves de rollback.
Comment Ali Run AIOps aborde le sujet
Ali Run AIOps aborde l’inférence privée d’abord comme de l’ingénierie d’infrastructure, ensuite comme de l’expérimentation IA. Le travail commence par des fondations Linux et réseau résilientes : nœuds GPU, reverse proxies, TLS, frontières d’identité, stockage, monitoring et récupération automatisée. Ensuite, nous ajoutons la couche IA — vLLM ou Ollama pour le serving local, Qdrant pour la recherche vectorielle, LangGraph pour les flux d’agents contrôlés, et Ansible pour le déploiement et la remédiation reproductibles.
Pour les clients financiers et les entreprises réglementées, l’objectif n’est pas de courir après chaque release de modèle. Il est de construire un modèle opérationnel de Sovereign AI capable de résister à l’examen : où les données restent, qui peut appeler le modèle, comment les changements sont approuvés, comment les incidents sont détectés, et comment l’activité se rétablit lorsqu’un composant d’inférence se comporte mal. vLLM 0.28.0 est une release utile. Les équipes gagnantes seront celles qui en feront une plateforme gouvernée, pas un endpoint non maîtrisé de plus.
Sources
- vLLM 0.28.0 changelog and release notes via What’s New
- vLLM project release dashboard on release.bar
- GitHub issue: prefix caching and MTP malformed output report in vLLM 0.28.0
- GitHub issue: distributed DeepSeek-V4-Pro startup hang report in vLLM 0.28.0
- European Commission: guidelines for providers of general-purpose AI models
Notes connexes
Sovereign AI · 7 sept. 2026
Configurateur open-source de sandbox d'évaluation de l'IA du Luxembourg
Le LIST et le SnT lancent un configurateur open-source de sandbox pour standardiser les tests de conformité aux EU AI Act et DORA.
Sovereign AI · 2 sept. 2026
La confidentialité de l’IA frontière passe sous garde client
Les nouvelles garanties d’Anthropic font de l’IA frontière un sujet d’architecture de garde pour les entreprises européennes régulées, pas seulement un choix fournisseur.