
AIOps & Automation · 25 août 2026
Le RCA passe des dashboards aux graphes de preuves
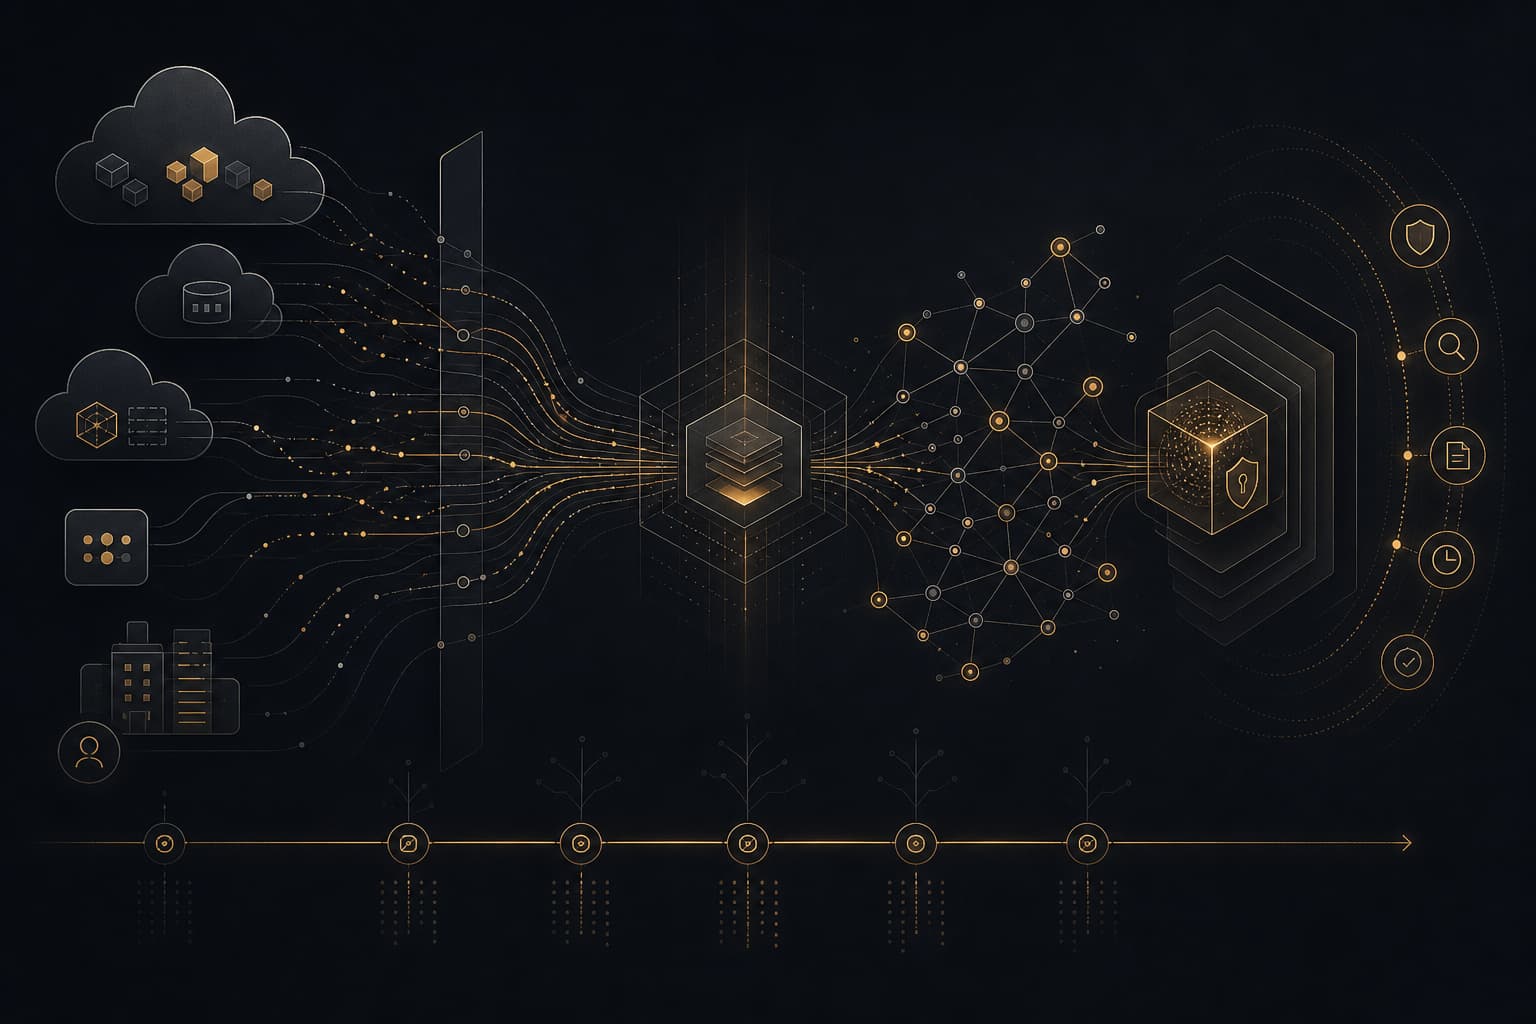
Les ingénieurs d’Atlassian ont publié une note de terrain CNCF utile le 24 août 2026 : l’analyse des causes racines dans de grands environnements cloud-native doit être traitée comme un problème de corrélation multi-signal, et non comme une chasse humaine à travers des dashboards déconnectés. Leur modèle combine métriques, logs, traces, fenêtres temporelles et topologie de services pour générer des hypothèses classées, avec les preuves et le récit qu’un intervenant peut valider.
Pour les institutions financières luxembourgeoises, les AIFM, les banques privées et les plateformes FinTech régulées, la partie intéressante n’est pas seulement l’algorithme. Le point stratégique est que la résilience opérationnelle passe de « nous avons du monitoring » à « nous pouvons reconstruire la causalité, démontrer la discipline de réponse, et réduire l’interruption métier ». C’est exactement la direction dans laquelle DORA, les attentes de reporting d’incidents de la CSSF et la responsabilité ICT des dirigeants poussent les responsables technologiques européens.
Impact réglementaire et métier
DORA a changé la conversation au niveau du conseil d’administration autour des incidents. Un événement ICT majeur n’est plus seulement un échec d’ingénierie ; il peut devenir une obligation de reporting réglementaire, un événement avec impact client, un sujet de risque tiers et une question de responsabilité de l’organe de direction. Les orientations de la CSSF pour les entités DORA indiquent clairement que l’organe de direction reste ultimement responsable du cadre de gestion du risque ICT, y compris la gouvernance, la supervision et l’allocation budgétaire. Le premier rapport annuel des ESAs sur les incidents majeurs liés aux ICT renforce également la dimension systémique du risque ICT dans le secteur financier de l’UE.
Cela signifie que le « mean time to innocence » n’est pas un modèle opérationnel sérieux. Lors d’un incident affectant le trading en ligne, les portails investisseurs, les flux de paiement, la distribution de données de fonds ou les plateformes de risque, la direction doit savoir rapidement trois choses : quel parcours utilisateur ou client est dégradé, quel service ou quelle dépendance est l’origine la plus probable, et quelles preuves soutiennent la décision de mitigation. Un chatbot IA générique au-dessus des logs ne résout pas cela. Une plateforme RCA correcte doit lier la télémétrie, la topologie, les enregistrements de changement et les décisions humaines dans un seul dossier d’incident.
L’article CNCF/Atlassian est utile parce qu’il donne aux dirigeants un langage pratique pour ce basculement. Le RCA automatisé y est présenté comme une corrélation entre types de signaux, temps et topologie. Cela s’aligne bien avec une résilience de type DORA, car cela produit une trace d’incident défendable : ce qui a changé, où les symptômes sont apparus, quelle dépendance amont a été impliquée, quelle équipe a été appelée, quelle mitigation a été retenue, et si l’hypothèse a été acceptée ou rejetée par les intervenants.
Il existe aussi un argument de coût. Beaucoup de banques et de prestataires de services aux fonds ont accumulé des dépenses d’observabilité sans réduire la friction pendant les incidents. Ils possèdent Prometheus, Grafana, ELK/OpenSearch, des traces, de l’APM et du ticketing — mais l’ingénieur d’astreinte agit encore comme moteur de corrélation à 02:00. Le ROI n’est pas un dashboard supplémentaire. Il consiste à réduire la charge cognitive, réduire le temps d’escalade, éviter les bridges fournisseurs inutiles, et donner à l’audit, au risque et aux opérations une vue cohérente de l’incident.
Blueprint architectural et opérationnel
L’architecture commence par une discipline peu spectaculaire : une télémétrie cohérente. OpenTelemetry est la bonne fondation, car il standardise les traces, les métriques et les logs entre services, et donne aux équipes plateforme un véritable graphe de dépendances issu du trafic de production, pas de diagrammes obsolètes. Dans des environnements régulés, ce graphe doit être traité comme un actif de contrôle. Il indique quels services s’appellent entre eux, quelles APIs soutiennent les processus métier critiques, et où une panne peut se propager.
Un pipeline RCA crédible doit contenir cinq couches.
Premièrement, définir la criticité des services. Tous les pods ne se valent pas. Il faut cartographier l’onboarding investisseur, l’exécution des ordres, la livraison de NAV, les workflows AML, l’initiation des paiements, le reporting et l’authentification client vers les services sous-jacents. C’est ici que l’IT, le risque et les opérations métier doivent s’accorder sur ce que signifie « critique ».
Deuxièmement, normaliser la télémétrie en événements prêts pour incident. Les métriques RED — rate, errors et duration — doivent être collectées par endpoint. Les logs doivent être suffisamment structurés pour permettre clustering et déduplication. Les traces doivent inclure les noms de services, les relations entre spans et les correlation IDs. Les reverse proxies et traffic gateways comme F5, NGINX, Envoy ou HAProxy doivent émettre une télémétrie de bord utile, car beaucoup d’incidents apparaissent d’abord comme de la latence, des pics de 5xx ou des échecs d’authentification à la frontière.
Troisièmement, construire le graphe de topologie. Dans les environnements Kubernetes, les service maps dérivées d’OpenTelemetry peuvent montrer les chemins d’appel réels. Dans les environnements hybrides, cela doit s’étendre aux machines virtuelles VMware ou Proxmox, aux bases de données, message brokers, systèmes de stockage, firewalls, API gateways et services tiers. Une plateforme de fonds luxembourgeoise échoue rarement dans Kubernetes seul. Elle peut échouer parce qu’une dépendance batch, un chemin DNS, une règle de proxy, un certificat, une intégration SFTP ou un flux de market data est devenu défaillant.
Quatrièmement, classer les hypothèses plutôt que prétendre connaître la réponse. Le modèle d’Atlassian est solide parce qu’il ne remplace pas l’ingénieur par une automatisation aveugle. Il produit des services soupçonnés d’être cause racine, des chemins de propagation, des preuves à chaque nœud, un score de confiance et une explication lisible. En pratique, cela devrait ouvrir un incident dans Jira, ServiceNow, Opsgenie ou PagerDuty avec des liens vers les panels Grafana exacts, les trace IDs, les clusters de logs et les déploiements récents.
Cinquièmement, n’utiliser l’IA qu’à l’intérieur de garde-fous. Un copilot d’incident peut résumer les preuves, suggérer des options de rollback, rédiger des mises à jour pour les parties prenantes et interroger les outils de télémétrie approuvés. Mais dans un environnement régulé, il ne doit pas exécuter de remédiation sans approbation explicite. Des workflows de type LangGraph, une inférence privée avec vLLM ou Ollama, et du retrieval sur une base de connaissance interne Qdrant peuvent être utiles — si les permissions d’outils, la journalisation des prompts, la classification des données et les gates d’approbation sont conçus dès le départ.
Le modèle opérationnel est simple : détecter l’impact utilisateur, cadrer le graphe de services affecté, collecter les anomalies dans les métriques/logs/traces, les corréler dans le temps, remonter les dépendances en amont, générer des hypothèses, laisser les intervenants valider, puis préserver les preuves et la trace de décision. C’est de l’AIOps avec une discipline d’ingénierie, pas du théâtre.
Ce que cela change en pratique
- Cessez de mesurer l’observabilité au nombre de dashboards. Mesurez si la télémétrie peut expliquer rapidement et de manière défendable un incident ayant un impact client.
- Faites de la topologie de services un actif gouverné. Maintenez les cartes de dépendances à jour et connectez-les aux services métier critiques.
- Corrélez les signaux avant d’impliquer les humains. Métriques, logs, traces, événements de déploiement, feature flags et tests synthétiques doivent arriver comme un seul contexte d’incident.
- Gardez les humains dans la boucle d’approbation. Le diagnostic automatisé a de la valeur ; la remédiation automatisée non approuvée dans la finance est un échec de contrôle en attente de se produire.
- Concevez pour la preuve d’audit. Préservez les hypothèses, les preuves, les décisions des intervenants, les horodatages et les communications pour DORA et les revues de risque internes.
- Traitez les tiers comme des nœuds du graphe. Les services cloud, plateformes SaaS, fournisseurs de paiement, flux de market data et sous-traitants ICT doivent être visibles dans le modèle d’incident.
- Exécutez des boucles de retour post-incident. Capturez si les hypothèses RCA étaient correctes, puis ajustez les seuils de détection, la pondération de topologie et les runbooks.
Comment Ali Run AIOps aborde ce sujet
Ali Run AIOps aborde ce sujet depuis la couche infrastructure vers le haut. Le travail commence par des fondations Linux, virtualisation et Kubernetes résilientes ; une télémétrie réseau et reverse-proxy correcte ; une observabilité Grafana/Zabbix/OpenTelemetry ; et une automatisation Ansible qui rend la récupération répétable. Une fois les données opérationnelles fiables, l’IA peut être introduite comme accélérateur contrôlé plutôt que comme boîte noire risquée.
Pour les équipes financières luxembourgeoises et européennes, l’architecture cible est une couche souveraine d’intelligence incident : télémétrie privée, retrieval de connaissance privé, assistance IA gouvernée et gates d’approbation humaine clairs. Que l’environnement repose sur VMware, Proxmox, bare metal, cloud ou Kubernetes hybride, l’objectif reste le même : réduire la durée des interruptions, préserver les preuves, maîtriser les coûts, et donner au management un récit de résilience qui tienne devant les auditeurs et les clients.
Sources
Notes connexes
AIOps & Automation · 1 sept. 2026
Les logs Go OpenTelemetry proches d’une couche de preuve stable
La télémétrie de logs Go approche la stabilité v1. À l’ère DORA, standardisez les preuves d’incident avant que les audits ne l’imposent.
Cloud & Virtualization · 27 août 2026
Kubernetes 1.37 rend les clusters IA auditables
Kubernetes 1.37 transforme les clusters IA en preuves de résilience : scheduling, métriques, identité et hygiène d’upgrade comptent désormais.